爬蟲存取驗證需分別檢查網站規則、實際請求及頁面回應,才能判斷特定服務是否曾存取特定網址。robots.txt 允許抓取不等於爬蟲已訪問、內容已收錄或 AI 一定引用。
企業可先確認希望服務哪些公開內容,再檢查 robots.txt、伺服器或 CDN 日誌及安全規則。不同 AI 服務的爬蟲用途和驗證方式可能不同;搜尋、使用者即時擷取和模型訓練不能一概視為同一種用途。
爬蟲存取驗證:怎麼判斷 AI 爬蟲真的讀到網站?
最直接的證據是適當範圍內的伺服器或 CDN 日誌,顯示可驗證來源對目標網址發出請求,以及網站回應的狀態。即使有成功回應,也只能證明特定請求被處理,不能證明內容一定被索引、使用或引用。
例如日誌顯示某服務的爬蟲請求一篇文章並收到成功狀態,仍需確認請求來源是否可信、是否有經過快取或導向,以及回應內容是否為預期頁面。日誌沒有紀錄也不必然證明服務從未取得內容,因為快取、不同網域或日誌保留範圍可能影響觀察。
先設定檢查時間、網域、網址與服務名稱,再整理請求時間、User-Agent、來源、路徑及回應狀態。日誌可能包含個資和安全資訊,應依網站管理規範限制存取及分享。
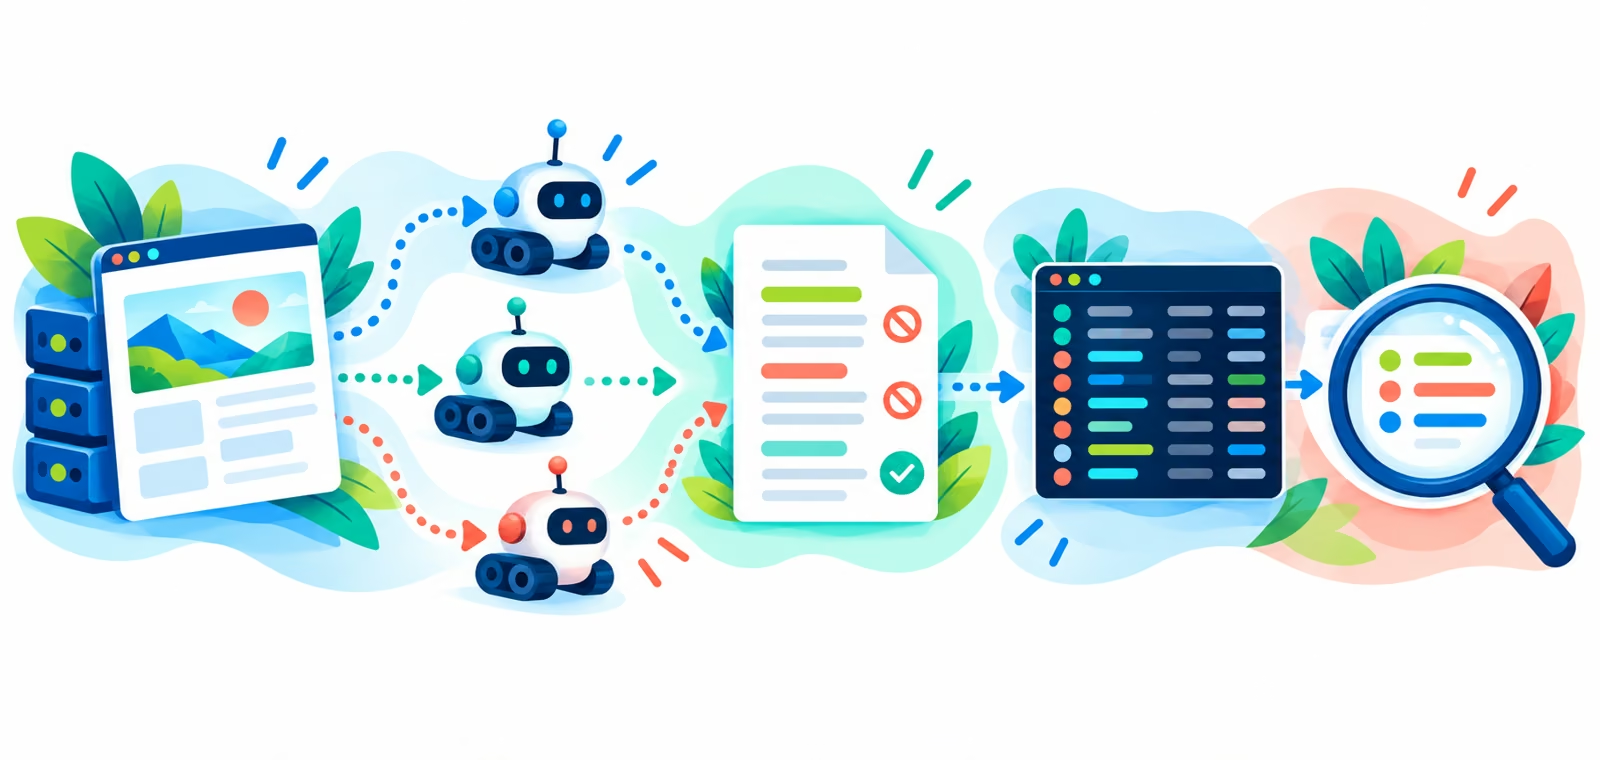
robots.txt 可以證明爬蟲已經來過嗎?
不可以。robots.txt 主要表達符合規則的爬蟲可否抓取哪些路徑,並不是訪問紀錄,也不保證爬蟲會依要求抓取或收錄內容。
先開啟目標網域根目錄下的 robots.txt,確認檔案可讀取、目標路徑是否受限制,以及不同 User-Agent 規則的作用範圍。子網域各自有自己的規則;轉址到其他主機時,也要檢查實際目的地。
robots.txt 是爬取偏好,不應當成隱藏機密資料的安全機制。需要限制公開存取的內容應使用適當驗證與權限;noindex 與禁止抓取也不同,若爬蟲不能讀取頁面,可能無法看到頁面內的 noindex。
不同 AI 爬蟲的用途有什麼差異?
各服務可能使用不同的爬蟲或請求方式處理搜尋、使用者要求及模型訓練;企業應依各供應商的最新文件決定規則,不要只憑名稱猜測用途。
OpenAI 的發布者與開發者說明區分 OAI-SearchBot 的搜尋內容存取與 GPTBot 的潛在訓練用途。允許或限制某個爬蟲是網站政策選擇,且供應商的行為與文件可能更新,實作前應重新核對。
Google 搜尋使用 Googlebot;Googlebot 文件說明抓取與索引控制的差別。不要因為想提升 AI 曝光就無差別停用防火牆、登入驗證或其他必要安全機制。
如何讀取日誌中的爬蟲請求?
日誌分析應從指定時間、主機與路徑篩選,再查看請求來源、User-Agent、狀態碼和導向。單憑 User-Agent 不能證明身分,因為任何客戶端都可能模仿該字串。
| 紀錄欄位 | 可以觀察什麼 | 不能單獨證明什麼 |
|---|---|---|
| 時間與路徑 | 何時請求哪些資源 | 後續是否收錄或引用 |
| User-Agent | 請求自稱的客戶端 | 來源身分真實性 |
| 來源位址 | 與供應商驗證資料比對 | 若清單過時則無法單獨判斷 |
| 狀態碼 | 成功、導向或拒絕等結果 | 頁面內容一定被完整處理 |
| CDN/WAF 事件 | 快取、挑戰或封鎖線索 | 網站是否已被搜尋服務採用 |
若網站經過 CDN,原始伺服器可能看不到被快取處理的全部請求,需依架構查看適當的 CDN 或防火牆紀錄。日誌保留時間、格式及權限不同,也會影響可觀察範圍。
如何驗證爬蟲來源,而不只看名稱?
應採用該供應商目前公布的驗證方式,例如官方 IP 範圍、驗證機器人機制或文件指定的 DNS 檢查。不同供應商的方法不同,不能把一家的驗證程序套用到所有服務。
Google 指出 User-Agent 可能被偽造,並提供驗證 Google 請求的方式。OpenAI 也提供其服務的公開資訊;實際檢查時應使用當前官方資料,而不是把曾經觀察到的單一 IP 永久視為可信。
若安全團隊需要調整規則,先核對影響的路徑、服務目的與驗證方式,再以最小必要範圍處理。避免僅憑可偽造的 User-Agent 建立全面放行規則,也不要為了讓未知機器人通過而關閉全站安全防護。
用模擬請求測試能證明 AI 讀到內容嗎?
不能。將自己的測試請求改成某個爬蟲的 User-Agent,只能觀察伺服器對該字串與測試來源的回應,不能代表請求來自該供應商,也不能證明其系統已抓取或引用頁面。
在有權限的情況下,可測試目標網址是否回應預期內容,並檢查導向、robots.txt、登入、地區限制與 JavaScript 渲染。若網站使用 WAF 或 CDN,測試結果可能因來源位置、驗證狀態及規則不同而與真正爬蟲不同。
將模擬測試、已驗證來源日誌和搜尋結果觀察分開記錄。搜尋結果看到頁面標題、日誌出現成功請求及 AI 產生引用,各自代表不同證據,不應互相替代。
AI Crawler Verification 排查順序怎麼安排?
先確認網站政策和目標網址,再檢查 robots.txt、公開回應、日誌與安全規則,最後依供應商提供的方式驗證來源。每一步都要記錄時間與限制,避免把允許、訪問與引用混成同一件事。
- 列出想檢查的服務、用途、網域與公開網址。
- 確認 robots.txt、登入要求及 noindex 等規則符合網站政策。
- 查看頁面回應、導向與必要內容是否可用。
- 在適當的伺服器、CDN 或 WAF 日誌中尋找請求及回應。
- 使用服務供應商目前公布的方法驗證來源。
- 記錄觀察限制並持續追蹤,不把單次結果當成永久狀態。
高雄、台中、台北企業在規劃網頁設計服務及網站設計合作流程時,可先確定內容開放政策、日誌負責人及安全規則維護方式。
AI 爬蟲檢查常見問題
以下整理 AI Crawler Verification 的常見疑問,實際規則仍應以各服務最新文件為準。
robots.txt 允許爬蟲就一定會被引用嗎?
不會。允許抓取不保證爬蟲訪問、索引、摘要或引用頁面。
日誌中有爬蟲名稱就代表來源是真的嗎?
不一定。User-Agent 可以偽造,應依供應商提供的驗證方式檢查來源。
成功回應代表整篇文章已被 AI 學習嗎?
不能由狀態碼推論。成功回應只說明特定請求得到成功回應,後續處理與用途取決於服務及其政策。
沒有看到日誌就代表服務從未抓取嗎?
不能確定。CDN 快取、日誌保留期限、其他網域與紀錄範圍都可能影響觀察。
延伸參考:企業網站如何規劃與建置?、SEO 與搜尋行銷如何規劃?。也可瀏覽商業與專業服務案例及教育與旅遊案例。